Isolierte Marken-Gedächtnisse im Agentur-Retainer: Wie Skalierung in der Praxis gelingt
Ein neuer Retainer startet. Im Kick-off liegen Präsentationen, alte Briefings, Freigabehinweise, Produktblätter und Chat-Nachrichten auf dem Tisch.
Nach zwei Wochen zeigt sich das eigentliche Problem: Nicht der Output bremst, sondern das Wissen.
Aussagen widersprechen sich, Formulierungen klingen je nach Bearbeiter anders, und jede Schleife beginnt wieder bei null. Genau hier setzen isolierte Marken-Gedächtnisse an: als sauber getrennte, nutzbare Wissensräume pro Kunde.
Doch wie macht ausgerechnet diese Trennung Retainer wirklich skalierbar?
Retainer scheitern selten am Output, sondern am fehlenden Marken-Gedächtnis
Answer-First:
Ein Retainer wird nicht unskalierbar, weil zu viel Content entsteht. Er wird unskalierbar, wenn Markenwissen im Kopf einzelner Personen, in verstreuten Dateien und in alten Freigabe-Mails steckt.
Gerade wiederkehrende Content-Modelle leben davon, dass Arbeit nicht jedes Mal neu beschrieben werden muss. Das zeigt sich seit Jahren bei laufenden Video- und Editing-Retainern: Sie nehmen administrativen Aufwand aus dem Tagesgeschäft, schaffen planbarere Lieferfenster und sorgen für mehr Konsistenz über Kanäle hinweg.
Der eigentliche Hebel ist aber nicht nur die Abrechnung in Monatsraten, sondern die fortlaufende Anreicherung von Kontext.
Das klassische Agenturproblem
Ohne dieses fortlaufende Gedächtnis entsteht das klassische Agenturproblem:
Das Team produziert zwar regelmäßig, muss aber bei jedem Asset erneut klären:
- welche Claims erlaubt sind,
- welche Tonalität gewünscht ist,
- welche Beispiele schon freigegeben wurden und
- welche Formulierungen tabu sind.
In der Praxis wächst so kein Retainer, sondern ein Archiv aus Zurufen.
Warum IT-Architektur entscheidend ist
Für IT-Verantwortliche ist das ein Architekturthema. Wenn Wissen nicht strukturiert erfasst, versioniert und pro Mandat getrennt wird, beschleunigt Automatisierung nur das Chaos.
Erst kommt der dokumentierte Ablauf, dann die Automatisierung. Andernfalls wird ein schlechter Zustand lediglich schneller reproduziert.
Kernaussage
Skalierbarkeit im Retainer entsteht nicht durch mehr Automatisierung allein, sondern durch ein belastbares, getrenntes Marken-Gedächtnis je Kunde.
Was ein isoliertes Marken-Gedächtnis wirklich enthält
Ein isoliertes Marken-Gedächtnis ist keine lose Dateisammlung. Es ist ein kuratierter Kundenraum, in dem nur die Informationen liegen, die für konsistente Generierung, Freigabe und Veröffentlichung gebraucht werden.
Mandantenfähigkeit: Daten und Regeln trennen
Technisch lässt sich das als mandantenfähiger Wissensraum verstehen, also als sauber getrennter Daten- und Kontextbereich pro Kunde. Organisatorisch ist es die Übersetzung des Briefings in dauerhaft nutzbare Regeln.
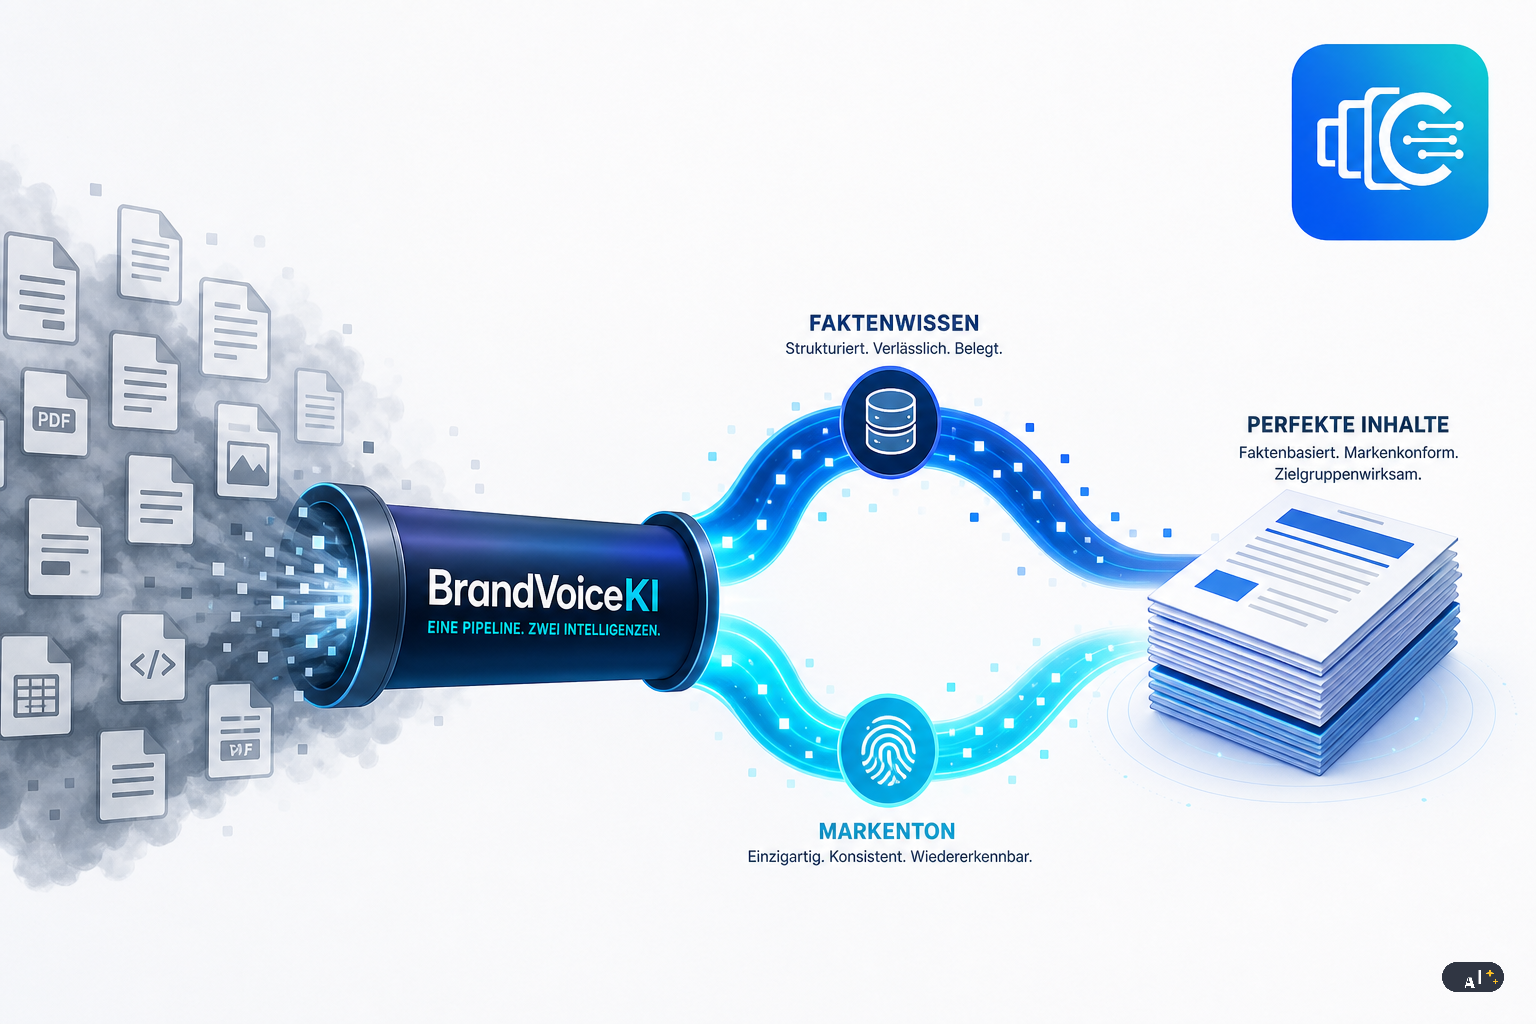
Entscheidend ist die Kombination aus Fakten, Stil und Grenzen. Denn eine KI kann nur dann wiederholbar arbeiten, wenn sie nicht nur weiß, was ein Kunde anbietet, sondern auch wie und was ausdrücklich nicht gesagt werden darf.
Sprachkarte vs. Faktenwissen
Für eine belastbare BrandVoiceKI reicht deshalb ein einzelner Stil-Prompt selten aus:
- Die Sprachkarte: Zuerst braucht es eine kompakte Sprachkarte, also klare Hinweise zu Tonfall, Satzlänge, Tabuwörtern, Kernbegriffen und bevorzugten Formulierungen.
- Das Faktenwissen: Danach kommt das Faktenwissen: Leistungen, Zielgruppen, Einwände, Nachweise, Produktlogik, Freigabegrenzen.
Fehlt diese Trennung, klingt der Output zwar ähnlich, ist aber fachlich unsauber.
Dynamische Aktualisierung im Arbeitsalltag
Sinnvoll ist ein Marken-Gedächtnis nur dann, wenn es mit dem realen Arbeitsalltag Schritt hält.
Neue Landingpages, überarbeitete Angebote, geänderte Preislogiken oder juristisch sensible Aussagen müssen versioniert nachgezogen werden. Sonst arbeitet das System mit einer Vergangenheit, die intern längst überholt ist.
Checkliste: Bestandteile eines isolierten Marken-Gedächtnisses
- Sprachkarte mit Tonalität, bevorzugten Formulierungen und Tabuwörtern
- Freigegebene Leistungs- und Produktbeschreibungen
- Zielgruppenbilder, typische Einwände und Antwortmuster
- Positiv- und Negativbeispiele aus bereits freigegebenem Content
- Kanalregeln für Blog, LinkedIn, E-Mail, Anzeigen und CMS
- Sensible Aussagen mit Freigabevorbehalt
- Historie von Änderungen, damit alte und neue Regeln nicht kollidieren
RAG statt Dauer-Nachbriefing: So greift die KI auf Markenwissen zu
Wenn ein Sprachmodell auf interne Markeninformationen zugreifen soll, ist nicht automatisch ein feinabgestimmtes Spezialmodell nötig. In vielen Fällen ist RAG („Abruf-gestützte Generierung“), der praktischere Weg.
Warum Halluzinationen entstehen
Der Grund ist einfach: Ein allgemeines LLM (großes Sprachmodell), kennt interne Kundendaten nicht.
Fragt man es dennoch nach Angebotsdetails, Textbausteinen oder Markenpositionierung, ergänzt es Lücken mit Wahrscheinlichkeiten. Genau daraus entstehen Halluzinationen.
RAG reduziert dieses Risiko, indem zuerst passende interne Inhalte abgerufen und erst danach Antworten formuliert werden.
Wie RAG technisch funktioniert
Der Ablauf folgt einer klaren Logik:
- Dokumente werden in sinnvolle Abschnitte zerlegt,
- diese Abschnitte in numerische Bedeutungsvektoren übersetzt,
- in einer Vektordatenbank abgelegt und
- bei einer Anfrage semantisch abgeglichen.
Das Modell antwortet dann auf Basis der gefundenen Stellen.
Für Agenturen ist das attraktiv, weil sich neue Briefings, FAQ-Listen oder Angebotsseiten einpflegen lassen, ohne das Grundmodell jedes Mal neu zu trainieren.
Feinabstimmung vs. RAG
Feinabstimmung (Anpassen der Modellgewichte), hat dennoch ihren Platz. Sie eignet sich eher, um Verhalten und Stil stärker zu prägen.
Für aktuelle Fakten, wechselnde Angebote und kundenindividuelles Wissen ist sie meist zu schwerfällig. In der Praxis hat sich deshalb eine Reihenfolge bewährt: erst Sprachkarte, dann RAG, Feinabstimmung nur als letzter Schritt.
Das passt besonders gut zu Retainern. Denn dort wächst Wissen laufend. Ein Modell, das dieses Wissen jedes Mal neu lernen müsste, wäre unnötig unflexibel.
Praxis-Tipp
Wenn Ihr Team heute noch viele Rückfragen in Chat, E-Mail und Freigabe-Calls klärt, ist das oft ein Zeichen für fehlendes abrufbares Markenwissen, nicht für mangelnde Prompt-Kompetenz.
Dokumentenhygiene, Chunking und Quellenregeln bestimmen die Antwortqualität
Ein isoliertes Marken-Gedächtnis ist nur so gut wie seine Pflege. Veraltete, doppelte oder widersprüchliche Dokumente führen direkt zu schwachen Antworten.
Der Dokumenten-Audit
Das ist kein Nebenaspekt, sondern der häufigste Stolperstein im RAG-Betrieb. Wenn im Wissensraum drei verschiedene Leistungsbeschreibungen kursieren, kann die KI nicht verlässlich erkennen, welche Fassung gilt. Was dann wie ein Modellfehler aussieht, ist oft ein Bestandsproblem.
Vor dem Roll-out lohnt sich deshalb ein nüchterner Dokumenten-Audit:
- Was ist aktuell?
- Wer gibt frei?
- Welche Quelle ist führend?
- Welche Dateien gehören nur ins Archiv?
Das Phänomen „Chunking“
Hinzu kommt das Thema Abschnittsgröße, oft „Chunking“ genannt:
- Werden Dokumente zu klein zerlegt, fehlt Kontext.
- Werden sie zu groß zerlegt, landet zu viel Rauschen in der Antwort.
Ein Preisblatt braucht andere Abschnitte als ein Messaging-Deck oder eine Fallstudie. Gute Systeme behandeln daher nicht jedes Dokument gleich, sondern passen die Struktur an den Dokumenttyp an.
Strikte Quellenregeln im Prompting
Ebenso wichtig sind strikte Quellenregeln im Prompting. Das Modell sollte angewiesen werden, Aussagen nur aus den abgerufenen Inhalten abzuleiten und Unsicherheiten offen zu markieren, statt Lücken frei zu ergänzen. Das ist für Entscheider oft wertvoller als eine glatte, aber unsichere Antwort.
Für IT-Verantwortliche bedeutet das: Nicht nur das Modell muss ausgewählt werden, sondern auch die Betriebsdisziplin rund um Quellen, Versionen und Prioritäten. Wer diesen Teil unterschätzt, bekommt keine Wissensplattform, sondern einen höflich formulierten Zufallsgenerator.
Governance schützt Marke und Mandat: Freigaben, Rollen und Qualitätsstufen
Je stärker Agenturen Content automatisieren, desto wichtiger wird ein klares Freigabe- und Kontrollmodell. Nicht jeder Inhalt braucht die gleiche Prüftiefe. Aber jeder Inhalt braucht eine definierte Verantwortlichkeit.
Gestufte Qualitätslogik
Bewährt hat sich eine gestufte Qualitätslogik:
- Strategische Leitinhalte (Positionierungsseiten, Whitepaper, sensible Kundenkommunikation): Sollten eng von Menschen geführt werden — menschlich konzipiert, mit KI unterstützt, manuell freigegeben.
- Serieninhalte (Blogentwürfe, Social-Varianten, E-Mail-Strecken): Können stärker von der KI vorbereitet und von Redakteuren redigiert werden.
- Routine-Inhalte (Metadaten, Varianten, Kurzfassungen, einfache Umformate): Lassen sich weiter automatisieren und stichprobenartig prüfen.
Wann prüft der Mensch?
Wichtig ist dabei nicht nur wer prüft, sondern wann.
Menschen sollten den Anfang und das Ende des Lebenszyklus kontrollieren: Themenwahl, Priorisierung, Freigabe und Erfolgsmessung.
Dazwischen kann KI viel Arbeit übernehmen, etwa Entwürfe, Variationen, Umformulierungen oder Kanaladaptionen. Dieses Modell entlastet Teams, ohne die Verantwortung zu entkoppeln.
Transparenz im Freigabepfad
Für den Betrieb empfiehlt sich ein nachvollziehbarer Freigabepfad mit Rollen, Identitäten und Protokollierung.
In produktiven Umgebungen ist zudem Transparenz über laufende Aufgaben wichtig:
- Welche Generierung läuft gerade?
- Welche ist fehlgeschlagen?
- Welche wartet auf Freigabe?
Ohne diesen Blick verliert der Betrieb schnell an Steuerbarkeit.
Kernaussage
Gute Governance bremst Retainer nicht aus. Sie verhindert, dass Tempo auf Kosten von Markenintegrität und Nachvollziehbarkeit erkauft wird.
Onboarding, Messung und Kapazitätsgrenzen machen Retainer skalierbar
Skalierbare Retainer entstehen nicht erst im Redaktionssystem, sondern schon im Onboarding. Wenn jede Kundeneinführung anders läuft, bleibt der Betrieb dauerhaft abhängig von Einzelpersonen.
Das Onboarding entkoppeln
Deshalb sollte das Onboarding vor der Automatisierung zerlegt werden:
- Welche Schritte sind zwingend?
- Welche davon hängen an der Geschäftsführung oder an Senior-Strategen?
- Was kann über strukturierte Formulare vor dem Kick-off eingesammelt werden?
Diese Trennung ist entscheidend, weil viele Agenturen nicht an zu wenig Nachfrage scheitern, sondern an Gründer-Flaschenhälsen. Erst wenn Briefing, Dateieinsammlung, Rollenklärung und Freigabelogik standardisiert sind, lässt sich ein Retainer sauber hochfahren.
Kapazitätsgrenzen als Qualitätsfaktor
Auch Kapazitätsgrenzen sind kein Rückschritt, sondern ein Qualitätsinstrument. Einige Dienstleister arbeiten bewusst mit begrenzten aktiven Retainern, um Reaktionsfähigkeit und Konsistency zu halten.
Für Agenturen mit KI-Unterstützung gilt dasselbe: Ein isoliertes Marken-Gedächtnis erhöht die Schlagkraft, ersetzt aber keine realistische Teamplanung.
Drei Ebenen der Erfolgsmessung
Bei der Messung reicht Reichweite allein nicht mehr aus. Aussagekräftiger sind Kennzahlen wie Kosten pro veröffentlichtem Asset, Konsistenz anhand einer Bewertungsmatrix, Anteil belastbar belegter Aussagen, Zitationsfähigkeit in KI-Antworten und die Entwicklung nachgelagerter Kennzahlen wie Reaktionszeit, Qualifizierung oder Abschlussnähe. Gerade im B2B-Umfeld ist das wichtiger als reiner Traffic, weil Kaufentscheidungen nicht linear verlaufen.
Wer Retainer strategisch führen will, sollte daher drei Ebenen messen:
- Betrieb: Durchlaufzeiten, Freigabeschleifen, Wiederverwendungsgrad von Wissen
- Marke: Konsistenz von Tonalität, Claim-Nutzung, Einhaltung von Tabubereichen
- Wirkung: Beitrag zu qualifizierten Anfragen, Sales-Gesprächen oder sichtbarer Marktpräsenz
So wird aus monatlicher Content-Produktion ein belastbarer Service mit nachweisbarer Steuerbarkeit.
Fazit
Retainer werden dann skalierbar, wenn Markenwissen nicht länger in Köpfen, Chats und Altdateien verteilt bleibt.
Isolierte Marken-Gedächtnisse schaffen dafür die Grundlage:
- getrennte Kundenräume,
- abrufbares Wissen,
- klare Freigaben und
- messbare Qualität.
RAG, gute Dokumentenhygiene und ein gestuftes Governance-Modell machen daraus keinen Hype, sondern einen belastbaren Betriebsansatz.
Wenn Sie prüfen möchten, wie sich ein solches Marken-Gedächtnis in Ihrem Team abbilden lässt, ist ein klar abgegrenzter Pilot mit einem Retainer-Kunden der sinnvollste nächste Schritt.