Brand-Voice-Chaos im Retainer-Modell beherrschen: Wie Sie mit Wissensbasen und Prompt-Strukturen Qualität sichern
Intro
Fünf Kunden parallel betreuen, mit demselben Kernteam, derselben KI und völlig unterschiedlichen Markenstimmen: Genau hier kippt im Retainer-Modell oft die Qualität.
Nicht, weil das Modell zu schwach wäre, sondern weil Briefings verteilt sind, Freigaben in Einzeldokumenten liegen und jede Person ihre eigenen Prompt-Gewohnheiten mitbringt.
Das Ergebnis ist bekannt: Texte passen fachlich halbwegs, klingen aber nicht nach dem jeweiligen Kunden.
Eine sauber aufgebaute Wissensbasis und klare Prompt-Strukturen sind der Ausweg. Doch wie setzt man beides so auf, dass es im Alltag wirklich trägt?
Brand-Voice-Chaos entsteht durch fehlenden Kontext, nicht durch zu wenig KI
Die meisten Stilbrüche entstehen nicht im Modell, sondern im Umfeld des Modells.
Wenn Kundenwissen, Freigaberegeln und Textbeispiele nicht systematisch bereitstehen, reagiert KI nur auf den gerade sichtbaren Ausschnitt.
In vielen Teams wird Prompting noch wie eine bessere Eingabeaufforderung behandelt: jemand schreibt eine Anweisung, ergänzt zwei Beispiele und hofft auf konsistente Ergebnisse. Für einzelne Aufgaben kann das funktionieren. Im Retainer-Modell mit mehreren Kunden reicht es nicht.
Hier kommt neben Prompt Engineering auch Kontext Engineering ins Spiel, also der Aufbau der gesamten Informationsumgebung, in der das Modell arbeitet.
Das ist geschäftlich relevant. Ein Sprachmodell verhält sich eher wie ein neuer Teamkollege als wie eine starre Vorlage: Je klarer Sie Ziel, Kontext, Ausschlüsse und Ausgabeform definieren, desto verlässlicher wird der Output.
Fehlt diese Umgebung, springt das Modell zwischen Tonalitäten, wiederholt Standardphrasen oder vermischt Kundensprache mit internem Agenturjargon.
Gerade bei mehreren Mandaten entsteht so ein stilles Risiko. Niemand bemerkt sofort, dass nicht „falsch“, sondern nur „nicht passend“ geschrieben wurde.
Genau dieses feine Abweichen kostet im Review die meiste Zeit.
Kernaussage
Wer Brand-Voice-Probleme nur mit „besseren Prompts“ lösen will, behandelt das Symptom. Die Ursause ist meist ein unzureichend organisierter Kontext.
Eine zentrale Wissensbasis schafft pro Kunde klare Leitplanken
Eine Wissensbasis bündelt das, was bisher in Briefings, Kommentaren, Präsentationen und Köpfen einzelner Mitarbeitender verteilt war.
Sie wird damit zur gemeinsamen Referenz für Tonalität, Freigaben und inhaltliche Grenzen.
Praktisch bedeutet das: Für jeden Kunden braucht es einen festen Informationssatz. Dazu gehören:
- Positionierung und Zielgruppen
- Verbotene Formulierungen und bevorzugte Begriffe
- Textbeispiele und Freigabehinweise
- Produktlogik und wiederkehrende Einwände
- Kanalbezogene Besonderheiten
Wichtig ist nicht nur die Sammlung, sondern die Struktur. Eine KI kann nur sauber abrufen, was eindeutig abgelegt wurde.
Technisch lässt sich das als semantisch verknüpfte Wissensschicht denken. Statt lose Dokumente abzulegen, beschreiben Sie Beziehungen:
- Welche Claims gehören zu welcher Zielgruppe?
- Welche Belege dürfen für welches Angebot genutzt werden?
- Welche Tonalität gilt für LinkedIn, welche für E-Mail, welche für Fachartikel?
Dieser Gedanke erinnert an moderne Wissensgraphen, also Beziehungsnetze aus Entitäten und Verknüpfungen. Für den Alltag heißt das vor allem: weniger Interpretationsspielraum.
Der Nutzen ist sofort sichtbar. Neue Teammitglieder, freie Mitarbeitende und KI-Systeme greifen auf dieselbe Quelle zu.
Das reduziert Rückfragen, beschleunigt Freigaben und verhindert, dass ein Kunde versehentlich mit Formulierungen eines anderen Kunden bedient wird.
Praxis-Tipp
Legen Sie pro Kunde mindestens diese Bausteine an:
- Markenprofil und Zielgruppenbild
- Sprachregeln: erwünscht, unerwünscht, tabu
- Freigegebene Kernbotschaften
- Kanalregeln je Format
- Positiv- und Negativbeispiele
- Versionsstand und verantwortliche Person
Strukturierte Prompt-Vorlagen sichern Ausgabeformat und Tonalität
Freitext-Prompts sind schnell geschrieben, aber schwer skalierbar. Strukturierte Prompt-Vorlagen machen aus implizitem Stilgefühl überprüfbare Regeln.
Hier lohnt ein technischer Blick, ohne unnötig tief abzutauchen. Viele Teams fordern Ausgaben im JSON-Format an, also als klar gegliedertes Datenobjekt. Das verbessert die Lesbarkeit für Systeme, garantiert aber noch nicht, dass die Struktur wirklich eingehalten wird.
Verlässlicher sind strukturierte Ausgaben mit Schema-Prüfung: Dabei wird nicht nur gültige Syntax, sondern ein vorgegebenes Feldmuster erzwungen. Für produktive Umgebungen ist dieser Unterschied zentral.
Ebenso wichtig ist die Trennung von Prompt und Schema. Wenn Ausgabeformate direkt in jeder Vorlage ausgeschrieben werden, entstehen schnell Abweichungen zwischen Datenmodell, Anwendung und KI-Anbindung.
Wartbarer ist ein Ansatz, bei dem das Schema aus zentralen Modellen eingespeist wird, etwa aus typisierten Definitionsschichten wie Zod oder Pydantic. So bleibt die Logik an einer Stelle gepflegt, statt in dutzenden Prompt-Varianten auseinanderzulaufen.
Für Brand Voice ist das besonders nützlich. Sie können nicht nur „Schreibe im Stil von Kunde A“ vorgeben, sondern konkrete Felder definieren:
- Tonalität
- Kernargument
- Risiko-Hinweis
- Call-to-Action
- Verbotene Phrasen
- Quellenlage
Das verkleinert den Interpretationsraum des Modells deutlich.
Forschung und Praxis zu strukturiertem Prompting zeigen, dass klar geführte Eingaben in komplexen Fachaufgaben oft präzisere Ergebnisse liefern als offene Freitext-Anweisungen.
Gleichzeitig gilt: Je starrer das Schema, desto empfindlicher wird das System bei fehlenden Informationen. Deshalb sollte in jeder Vorlage geregelt sein, wie mit Lücken umzugehen ist.
Kernaussage
Gute Prompt-Strukturen definieren nicht nur, was erzeugt werden soll, sondern auch, wie mit Unsicherheit, fehlenden Daten und verbotenen Aussagen umzugehen ist.
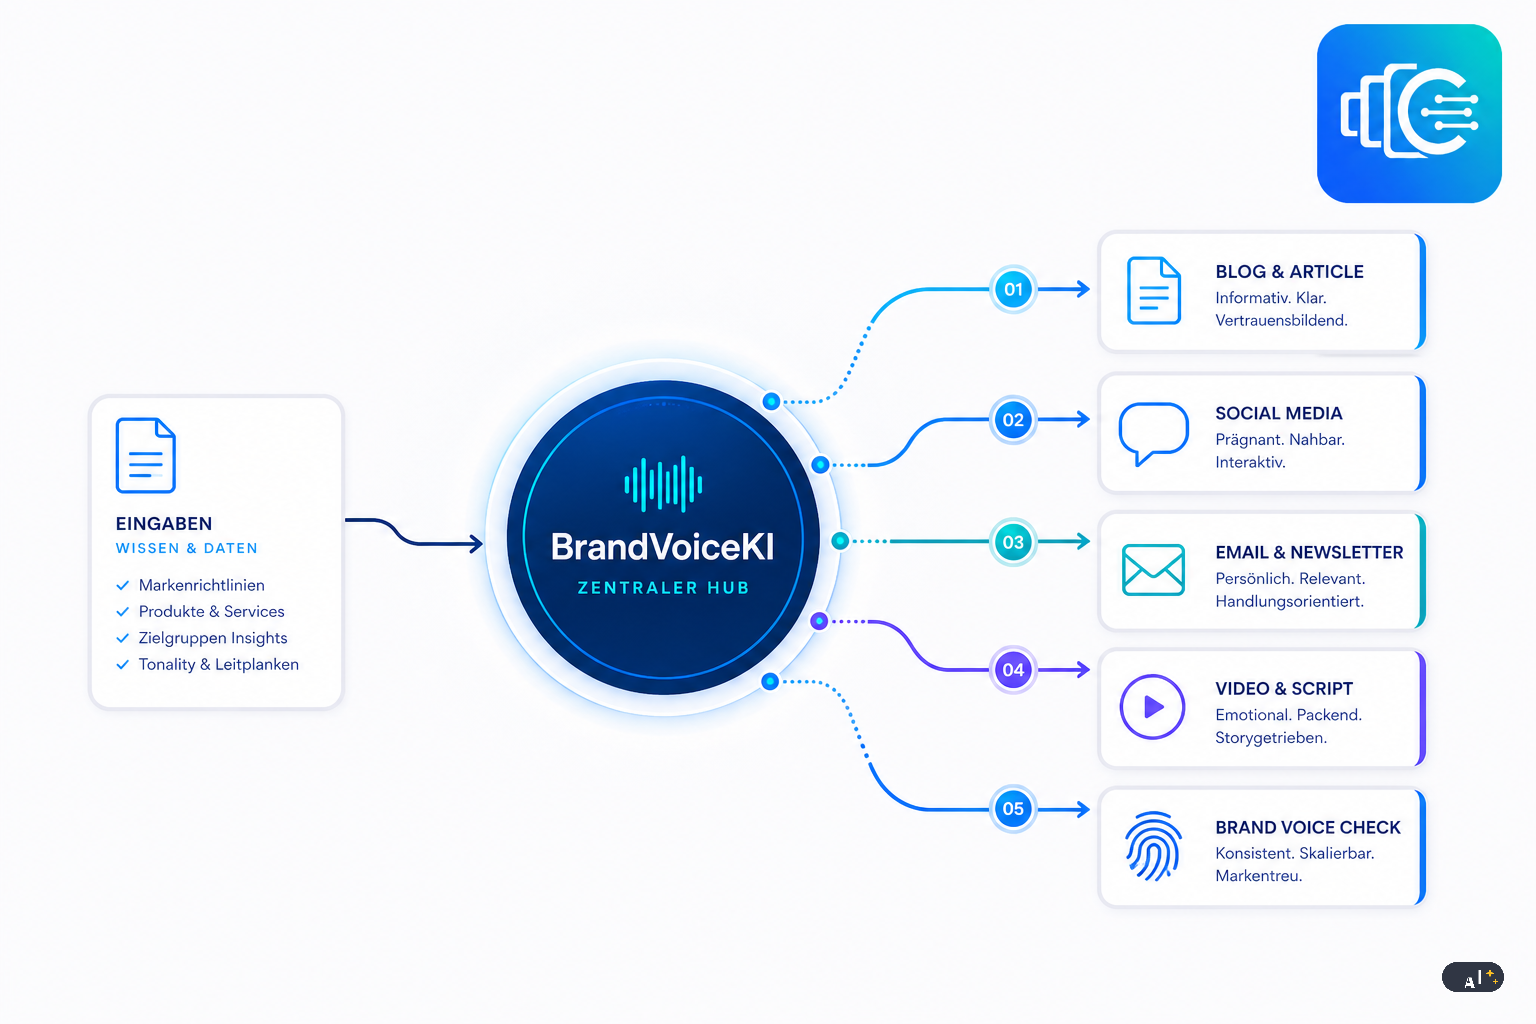
BrandVoiceKI funktioniert nur mit sauber getrennten Kontextschichten
BrandVoiceKI wird erst dann belastbar, wenn Kundenkontext, Aufgabenlogik und Ausgabeformat getrennt gepflegt werden.
Diese Trennung verhindert, dass jedes neue Briefing die Grundlogik neu erfinden muss.
Bewährt hat sich ein mehrschichtiger Aufbau:
- Schicht eins enthält dauerhafte Markenregeln des Kunden.
- Schicht zwei beschreibt die konkrete Aufgabe, etwa ein Fachbeitrag, eine Landingpage oder ein Newsletter.
- Schicht drei definiert die Ausgabeform.
- Schicht vier ergänzt situative Eingaben aus dem aktuellen Briefing.
Damit vermeiden Sie, dass ein spontaner Zuruf im Tagesgeschäft versehentlich die gesamte Tonalität überschreibt.
Diese Trennung ist auch deshalb wichtig, weil Sprachmodelle sensibel auf Form und Reihenfolge reagieren. Schon kleine Verschiebungen an Token-Grenzen, also den internen Textbausteinen eines Modells, können Ausgaben verändern.
Modelle profitieren daher von stabilen, priorisierten Prompt-Bausteinen statt von jedes Mal neu formulierten Komplettanweisungen.
Für größere Umgebungen können typisierte Prompt-Sprachen oder modellunabhängige Markup-Ansätze hilfreich sein. Entscheidend ist weniger das konkrete Werkzeug als der architektonische Gedanke:
Die Marke ist kein Absatz im Prompt, sondern eine eigene, versionierte Schicht.
Wenn das Kontextfenster knapp wird, müssen niedrig priorisierte Inhalte zuerst weichen, nicht die Brand-Regeln. Auch für lange Quelltexte ist das relevant; hier helfen mehrstufige Verfahren, bei denen Abschnitte getrennt ausgewertet und erst danach zusammengeführt werden.
So entsteht aus „einem guten Prompt“ ein belastbares System. Genau das braucht ein Team, das fünf Kunden mit einer gemeinsamen Infrastruktur betreut.
RAG und MCP verbinden Wissensbasis, Werkzeuge und aktuelle Daten
Eine statische Wissensbasis reicht nicht aus, wenn Briefings, Produktdaten oder Freigaben laufend wechseln. Hier kommen RAG und MCP als verbindende Architekturbausteine ins Spiel.
RAG steht für abrufgestützte Generierung (Retrieval-Augmented Generation). Vereinfacht gesagt durchsucht das System zunächst relevante Inhalte in einer Wissensbasis und gibt nur passende Ausschnitte an das Modell weiter.
Technisch geschieht das oft über Vektorsuche, also den semantischen Abgleich von Bedeutungen statt reiner Schlagwörter. Für mehrere Kunden ist das ideal: Die KI bekommt nicht „alles“, sondern nur den Kontext des richtigen Mandats.
MCP ist ein Protokoll für standardisierten Kontextaustausch zwischen Modellen, Datenquellen und Werkzeugen. Damit lässt sich regeln, wie ein System auf Freigabestände, Redaktionsdaten, Produktdatenbanken oder Tickets zugreift.
Der geschäftliche Vorteil liegt weniger im Schlagwort als in der Entkopplung: Wissensbasis, Modell und angebundene Werkzeuge müssen nicht als starres Gesamtsystem gebaut sein.
Das reduziert Halluzinationen nicht automatisch, hilft aber spürbar, wenn die KI auf aktuelle, kontrollierte Informationen zugreifen kann, statt auf Vermutungen.
Wichtig bleiben Zugriffskontrolle, Synchronisation und eine klare Trennung vertrauenswürdiger von unzuverlässigen Eingaben. Externe oder nutzergenerierte Inhalte sollten deshalb semantisch gekennzeichnet und isoliert eingebunden werden, damit Anweisungen und Inhalt nicht vermischt werden.
Praxis-Tipp
Prüfen Sie bei Ihrer Architektur drei Fragen:
- Holt die KI nur kundenspezifische Inhalte ab?
- Sind aktuelle Freigaben technisch erreichbar?
- Werden externe Eingaben klar von Systemregeln getrennt?
So führen Sie Wissensbasis und Prompt-Strukturen im Retainer-Modell ein
Der beste Aufbau scheitert, wenn er als Großprojekt startet. Sinnvoller ist ein kontrollierter Einstieg mit einem Kunden, einem Format und einem klaren Prüfbild.
Starten Sie mit einem wiederkehrenden Inhaltstyp, etwa Fachbeiträgen, Produkttexten oder E-Mail-Strecken. Definieren Sie dafür eine minimale Wissensbasis und eine feste Prompt-Struktur.
Messen Sie dann nicht nur Geschwindigkeit, sondern vor allem Nachbearbeitungsaufwand:
- Wie oft muss Tonalität korrigiert werden?
- Welche Felder fehlen regelmäßig?
- Wo entstehen Freigabeschleifen?
Gerade diese Beobachtungen zeigen, ob Ihre BrandVoiceKI tragfähig ist.
Für den Betrieb sind drei Punkte entscheidend:
- Versionierung: Sowohl Wissensbasis als auch Prompt-Schemata sollten nachvollziehbare Versionsstände haben.
- Schrittweise Erweiterung: Beginnen Sie mit Pflichtfeldern und ergänzen Sie nur das, was im Alltag wirklich genutzt wird.
- Menschliche Endkontrolle: Strukturierte Systeme erhöhen die Verlässlichkeit, ersetzen aber keine redaktionelle Verantwortung.
Beachten Sie auch die Grenzen. Strukturierte Prompts schaffen Ordnung, können aber spröde werden, wenn jeder Sonderfall als Pflichtfeld modelliert wird.
Dann steigt der Pflegeaufwand, und Teams umgehen das System mit freien Zusatzanweisungen. Genau dadurch kehrt das Chaos zurück.
Ein pragmischer Einführungsplan sieht deshalb so aus:
Checkliste für die Einführung
- Einen Pilotkunden mit hohem Wiederholungsgrad wählen
- Sprachregeln und Negativbeispiele zuerst dokumentieren
- Ausgabeformat als Schema definieren
- RAG nur auf freigegebene Quellen begrenzen
- Review-Kriterien für Brand Voice schriftlich festhalten
- Änderungen an Wissensbasis und Prompt-Struktur versionieren
Wenn Sie diesen Weg gehen, verlagert sich die Arbeit. Weg vom ständigen Umtexten. Hin zum gepflegten System, das gute Erstfassungen erzeugt.
Fazit
Brand-Voice-Chaos im Retainer-Modell ist selten ein KI-Problem im engeren Sinn. Meist fehlt eine belastbare Kombination aus zentraler Wissensbasis, sauber getrennten Kontextschichten und strukturierten Prompt-Vorlagen.
Wenn Sie BrandVoiceKI so aufsetzen, entsteht aus verstreutem Kundenwissen ein wiederholbarer Arbeitsrahmen, der Freigaben erleichtert und stilistische Ausreißer spürbar reduziert.
Wenn Sie das Thema angehen wollen, starten Sie mit einem kleinen Pilotfall und prüfen Sie nüchtern, wo weniger Nacharbeit und mehr Konsistenz tatsächlich im Alltag ankommen.